La generación de imágenes IA de bajo costo es un desafío complejo en producción. Los usuarios esperan resultados rápidos, los costos de GPU escalan con el tráfico y la calidad depende de qué réplica procese cada solicitud.
En este artículo aprenderás cómo AWS Professional Services construyó una solución que genera imágenes de alta calidad ejecutando el modelo Z-Image-Turbo en aceleradores AWS Inferentia2 dentro de Amazon ECS, reduciendo costos y garantizando consistencia en cada generación.
El problema del costo en generación de imágenes
Un modelo de difusión genera imágenes refinando ruido aleatorio a través de pasos de desruidización sucesivos. Z-Image-Turbo requiere solo 8 pasos, pero cada uno ejecuta el modelo completo de 6 mil millones de parámetros. El modelo consume 11,5 GB solo en pesos, más 1,6 a 4,1 GB de memoria de trabajo durante la inferencia.
La limitación crítica es que un modelo saturado consume toda la capacidad del acelerador. No hay espacio para procesar solicitudes en paralelo o por lotes. El hardware está generando una imagen o está inactivo, sin término medio. La utilización del acelerador determina directamente el costo por imagen.
En un inf2.8xlarge a 1,97 dólares por hora, una imagen de 512 píxeles cuesta aproximadamente 0,003 dólares y una de 1024 píxeles cuesta 0,011 dólares. Estos números son viables para una funcionalidad integrada, pero solo si los contenedores inician rápidamente. El verdadero cuello de botella es la compilación del modelo.
Arquitectura serverless y containerizada con Inferentia2
La solución despliega tres servicios ECS independientes, uno por cada resolución (512, 768 y 1024 píxeles), cada uno respaldado por un balanceador de carga interno. Los artefactos compilados se cachean en Amazon EFS, permitiendo que los contenedores inicien en aproximadamente 2 minutos en lugar de 30 o más.
El flujo comienza cuando un usuario envía un mensaje a través del frontend React. Amazon CloudFront termina la conexión TLS y reenvía la solicitud WebSocket a Amazon API Gateway, que valida el token JWT de Amazon Cognito y enruta al manejador Lambda.
Lambda selecciona la resolución objetivo y llama al endpoint /invocations del balanceador de carga interno con un encabezado X-Target-Resolution. El balanceador enruta al grupo de destino del servicio ECS correspondiente, donde el contenedor codifica el mensaje, ejecuta 8 pasos de desruidización y transmite fotogramas JPEG intermedios. Lambda retransmite cada fotograma como mensaje binario WebSocket al cliente.
El viaje completo desde la solicitud hasta la imagen final toma entre 5 y 20 segundos según la resolución. Cada paso de desruidización produce un fotograma progresivamente más nítido, lo que permite transmitir la generación en tiempo real.
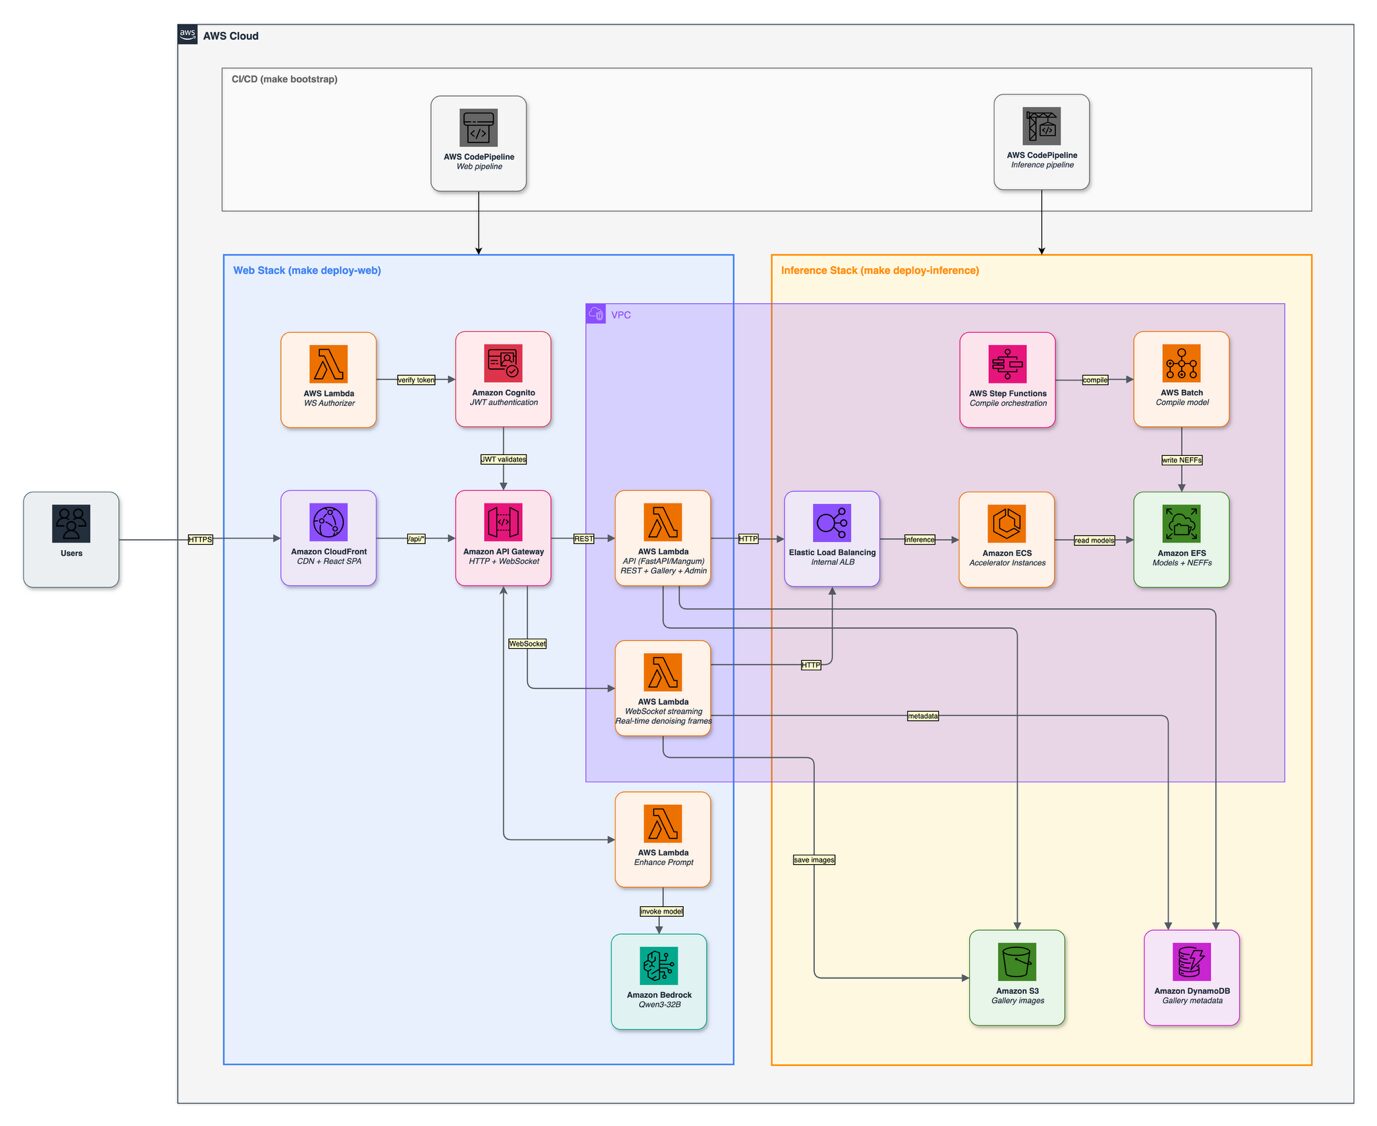
- Usuario ingresa un mensaje en el frontend React servido por Amazon CloudFront
- CloudFront termina TLS y reenvía la actualización WebSocket a Amazon API Gateway
- API Gateway valida el JWT de Amazon Cognito y enruta al manejador Lambda
- Lambda selecciona la resolución y llama al balanceador de carga interno con el encabezado de resolución
- El balanceador enruta al servicio ECS correspondiente que ejecuta los 8 pasos de desruidización
- El contenedor transmite fotogramas JPEG intermedios a través de Lambda como mensajes WebSocket binarios
- El cliente recibe la imagen final en 5 a 20 segundos según la resolución
Servicios AWS que intervienen
AWS Inferentia2
Acelerador de aprendizaje automático optimizado para transformadores, proporciona dos NeuronCores con 16 GB de memoria de alto ancho de banda cada uno en instancias inf2.8xlarge.
Amazon ECS
Ejecuta tres servicios containerizados independientes, uno por resolución, con auto-escalado basado en demanda y gestión de instancias.
Amazon EFS
Almacena artefactos compilados en formato NEFF para que los contenedores los monten al iniciar, eliminando la compilación por instancia.
Amazon API Gateway
Valida solicitudes WebSocket, autentica mediante Amazon Cognito y enruta hacia el manejador Lambda.
AWS Lambda
Selecciona la resolución, invoca el servicio ECS apropiado y retransmite fotogramas como mensajes WebSocket al cliente.
Amazon Cognito
Proporciona autenticación mediante tokens JWT para validar usuarios antes de procesar solicitudes de generación.
Amazon CloudFront
Distribuye el frontend React, termina conexiones TLS y reenvía solicitudes WebSocket a API Gateway.
AWS Step Functions
Orquesta la compilación del modelo durante el pipeline CI/CD, coordinando funciones Lambda y trabajos AWS Batch.
AWS Batch
Ejecuta trabajos de compilación en instancias inf2.8xlarge para generar artefactos NEFF y almacenarlos en EFS.
Amazon S3
Almacena modelos, código fuente y artefactos compilados para el pipeline de integración continua.
Casos de uso
Plataformas de contenido creativo
Agencias de diseño y estudios de producción pueden ofrecer generación de imágenes bajo demanda a clientes sin incurrir en costos prohibitivos de GPU. La transmisión en tiempo real de fotogramas intermedios mejora la experiencia del usuario.
Herramientas de comercio electrónico
Tiendas en línea generan variaciones de imágenes de productos para catálogos. La separación por resolución permite escalar independientemente según patrones de tráfico, optimizando costos.
Plataformas de marketing y publicidad
Equipos crean múltiples versiones de anuncios visuales rápidamente. La determinación del modelo garantiza que prompts idénticos produzcan resultados consistentes en todas las instancias.
Aplicaciones de juegos y entretenimiento
Desarrolladores integran generación de arte procedural en juegos sin preocuparse por latencia o costos impredecibles. El caché en EFS asegura escalado horizontal sin penalizaciones de compilación.
Consideraciones de costos, seguridad y operación
- Verifica las cuotas de servicio de tu cuenta AWS para instancias On-Demand Inf2. Las cuentas nuevas típicamente comienzan con cuota 0 para instancias Inf; solicita un aumento en la consola de cuotas de servicio.
- Cachear artefactos compilados en EFS es crítico: cambios en código HTTP o configuración no disparan recompilación, ahorrando 25 minutos en la mayoría de despliegues. Solo cambios al modelo o formas de tensores fuerzan recompilación.
- Configura el retardo de desregistro en 120 segundos para permitir que inferencias en vuelo se completen antes de drenar instancias durante actualizaciones.
- Usa Amazon Cognito para autenticar usuarios y valida tokens JWT en API Gateway. Almacena modelos compilados en EFS con acceso de solo lectura desde los contenedores.
- Monitorea la utilización del acelerador y el tiempo de respuesta. Tres servicios separados permiten escalar cada resolución independientemente según demanda real.
- El modelo Z-Image-Turbo es determinista: el mismo mensaje y semilla producen idéntica salida byte a byte, garantizando consistencia sin necesidad de sincronización entre instancias.
Si quieres aplicar estas recomendaciones en tu cuenta de AWS, revisa nuestro servicio de Optimización Cloud.
Preguntas frecuentes
¿Por qué separar tres servicios ECS por resolución?
Cada resolución tiene diferente perfil de memoria e inferencia. Separar servicios permite escalar independientemente: tráfico de 512 píxeles es típicamente 3 a 5 veces mayor que 1024 píxeles. Un servicio único requeriría intercambiar artefactos compilados por solicitud, desperdiciando memoria.
¿Cuánto tiempo tarda el primer despliegue?
El primer despliegue tarda aproximadamente 45 minutos, incluida compilación del modelo. Despliegues posteriores que no tocan código del modelo toman alrededor de 20 minutos. La compilación ocurre una sola vez en el pipeline CI/CD y se cachea en EFS.
¿Qué es Z-Image-Turbo y por qué es importante?
Es un modelo de difusión de 6 mil millones de parámetros que genera imágenes en 8 pasos en lugar de 20 a 50. Determinista: el mismo mensaje y semilla producen idéntica salida. Optimizado para transformadores, funciona eficientemente en AWS Inferentia2.
¿Cómo se garantiza consistencia entre instancias?
El modelo es determinista: mismo mensaje, semilla y resolución producen idéntica salida byte a byte. Cualquier instancia puede servir solicitudes intercambiablemente. No se requiere sincronización ni estado compartido más allá del caché de EFS.
¿Cuál es el costo aproximado por imagen?
En us-east-1, una imagen de 512 píxeles cuesta aproximadamente 0,003 dólares y una de 1024 píxeles cuesta 0,011 dólares, basado en tarifa de 1,97 dólares por hora de inf2.8xlarge. Verifica precios actuales en tu región.
Generación de imágenes IA de bajo costo viable en producción
La generación de imágenes IA de bajo costo en producción requiere resolver tres problemas simultáneamente: latencia, costo y consistencia. Esta arquitectura los resuelve mediante AWS Inferentia2 para acelerar inferencia, caché en EFS para eliminar compilación repetida y separación de servicios por resolución para escalar eficientemente.
El patrón clave es compilar una sola vez durante el pipeline CI/CD, cachear artefactos en EFS y montar la misma copia en cada contenedor. Esto reduce el tiempo de inicio de 30 minutos a 2 minutos, transformando el escalado horizontal en un problema estándar de programación de contenedores.
Para equipos que construyen pipelines de contenido o herramientas creativas, esta arquitectura demuestra que es posible servir generación de imágenes de alta calidad a escala sin incurrir en costos prohibitivos. El código está disponible en GitHub, permitiendo despliegue en tu cuenta AWS en aproximadamente 45 minutos para la primera compilación.
Fuente: High-quality cost-effective AI image generation on Amazon ECS, blog oficial de AWS (en inglés). Este artículo es un análisis propio en español; el diagrama pertenece a AWS.